Os modelos semânticos no Power BI e no Fabric consomem memória e quando essa memória se esgota, as atualizações falham e as consultas expiram. Este artigo explica por que razão o tamanho do modelo é importante, como a memória se comporta na prática e seis padrões práticos que pode aplicar para otimizar o seu modelo.
Por que é que o tamanho do modelo é importante
No Power BI e no Fabric o tamanho do modelo equivale ao consumo de memória. Quanto mais dados o seu modelo contiver, maior será a sua utilização de memória.
Exceder os limites de memória pode levar a:
- Falhas nas atualizações
- Expiração de consultas
- Aumento do consumo de capacidade
Quando isso acontece, sobram apenas duas opções:
- Otimizar o modelo
- Aumentar a capacidade
Por que é que a otimização de memória é importante
Manter o tamanho do modelo sob controlo oferece vários benefícios principais:
- Menor custo: Modelos mais pequenos reduzem a necessidade de SKUs do Fabric superiores ou licenças de upgrade
- Atualização mais rápida: Menos dados e melhor compressão melhoram os tempos de atualização
- Melhor desempenho: O Copilot, os agentes de dados e as consultas DAX funcionam de forma mais eficiente
Como a memória se comporta na prática
Limites de memória no Fabric
Um dos aspetos mais importantes a compreender é que, no Fabric, a memória funciona como um limite rígido.
Ao contrário do processamento, que pode escalar ou aumentar temporariamente, a memória não pode exceder a capacidade alocada. Quando o limite é atingido, as operações falham.
Características principais:
- Os limites de memória são aplicados por modelo semântico
- Um único modelo demasiado grande falhará independentemente dos outros
O desafio oculto: memória durante a atualização
Um dos aspetos mais negligenciados da memória é o seu comportamento durante a atualização. No modo de Importação, numa atualização completa:
- O modelo atual permanece em memória
- Uma nova cópia do modelo é processada em paralelo
- Acrescenta sobrecarga de processamento e utilização de memória para consultas
Isto significa que um modelo que “cabe” em repouso pode ainda assim falhar durante a atualização por falta de espaço disponível. Ao conceber um modelo, considere sempre capacidade de memória adicional, não apenas o tamanho final do modelo.
Memória vs. tamanho do ficheiro
É importante não confundir o consumo de memória com o tamanho do ficheiro .pbix.
- Memória: VertiPaq (dados comprimidos carregados em RAM)
- Tamanho do PBIX: Ficheiro comprimido em disco + metadados
Um modelo pode parecer pequeno em disco mas ainda assim consumir memória significativa quando carregado.
Modos de armazenamento: compromissos, não soluções
Alterar o modo de armazenamento não elimina as restrições de memória, apenas as redistribui:
- Importação: Melhor desempenho, consumo de memória previsível
- Direct Lake: Carrega dados a pedido, ainda consome memória durante as consultas
- DirectQuery: Consumo mínimo de memória, mas consultas mais lentas e maior carga na fonte
Os modos de armazenamento alteram como a memória é utilizada, não se é utilizada.
Medir antes de otimizar
Antes de fazer qualquer alteração, é necessária uma visibilidade clara sobre o sistema. Para isso, pode utilizar ferramentas como:
- VertiPaq Analyzer (Tabular Editor 3, DAX Studio)
- Memory Analyzer (notebooks do Fabric)
Permitem identificar exatamente quais as colunas que consomem mais memória e é assim que se passa de:
“O meu modelo é demasiado grande” para “Esta coluna específica é o problema.”
Seis padrões comprovados para otimizar o tamanho do modelo
Estes seis padrões vão da remoção de dados não utilizados a estratégias mais avançadas de compressão e agregação.
Padrão 1: Reduzir dados desnecessários
Esta é a forma mais simples e eficaz de reduzir o tamanho do modelo semântico e o objetivo é direto: incluir apenas o que realmente precisa.
Na prática, isto significa:
- Remover colunas ou tabelas não utilizadas
- Filtrar linhas desnecessárias (limitar dados históricos)
- Agregar dados mais antigos em vez de armazenar todos os detalhes
É comum incluir dados extra “por precaução”, no entanto, isso tem um custo. Se uma coluna ou conjunto de dados não suporta um requisito de relatório claro, provavelmente não pertence ao seu modelo.
Se estiver a refatorar um modelo existente, é útil identificar colunas que não são utilizadas em cálculos ou relações. O Best Practice Analyzer do Tabular Editor inclui uma regra que ajuda a detetar estas colunas não utilizadas.
Padrão 2: Reduzir a cardinalidade e o tamanho do dicionário
E se identificou colunas grandes que são essenciais para o modelo e não podem ser removidas? A solução passa por reduzir a cardinalidade e o tamanho do dicionário como próximo passo.
Colunas de alta cardinalidade (colunas com muitos valores únicos) são uma das maiores causas de modelos de grande dimensão. O VertiPaq armazena um dicionário de valores únicos por coluna, pelo que mais unicidade equivale a mais memória.
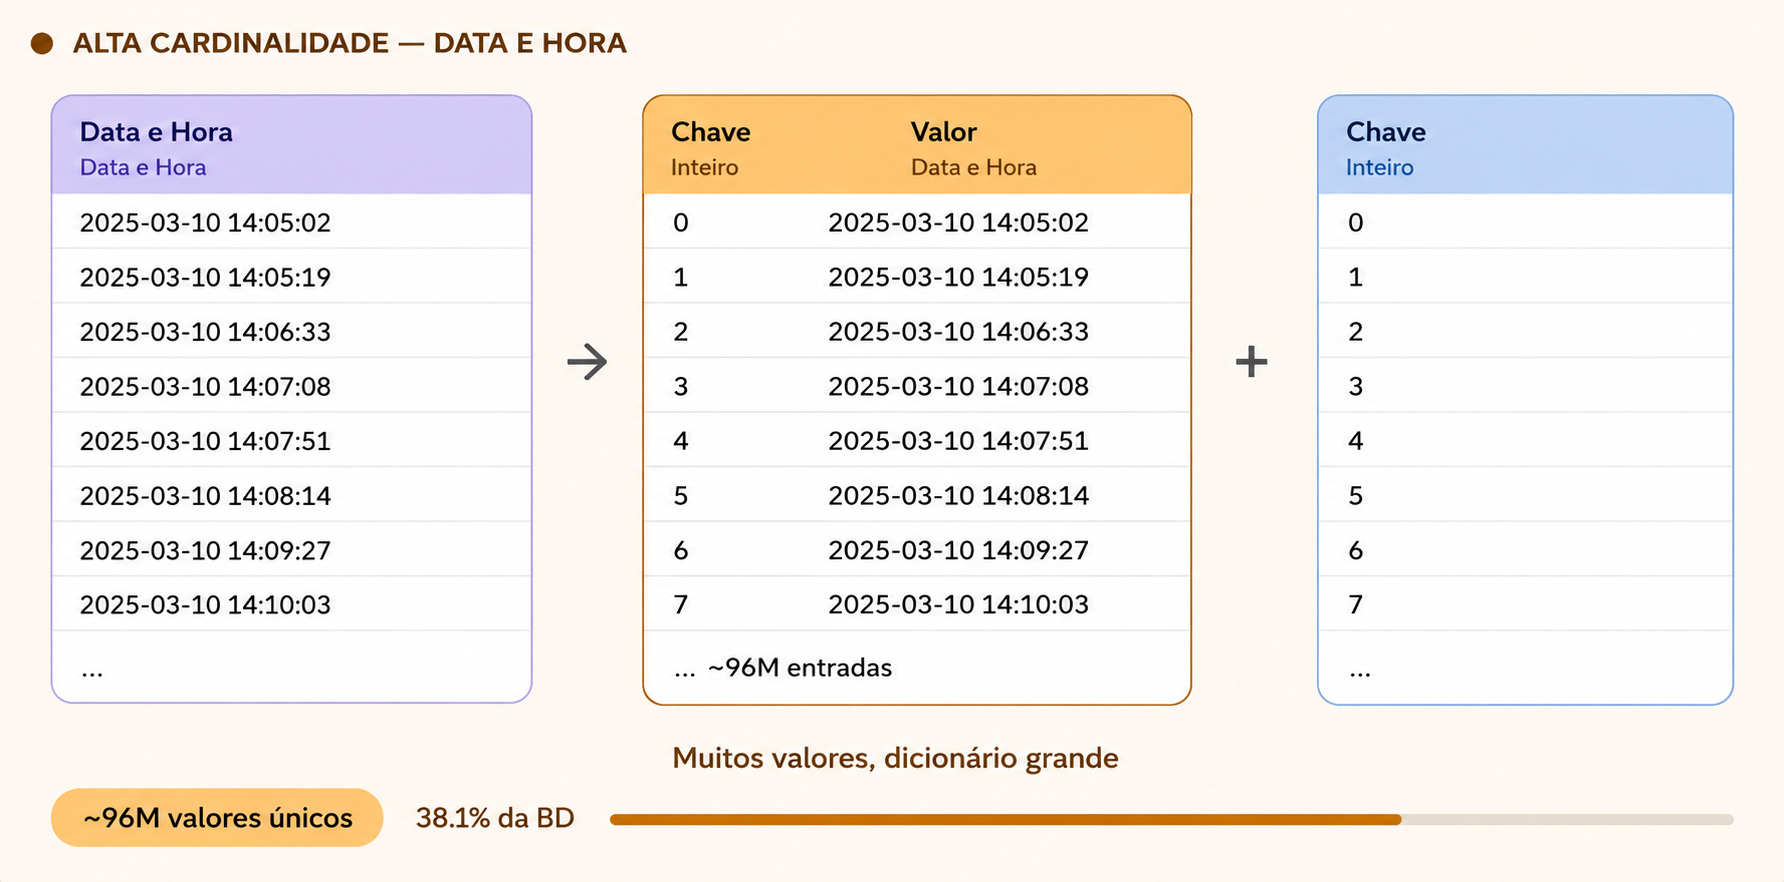
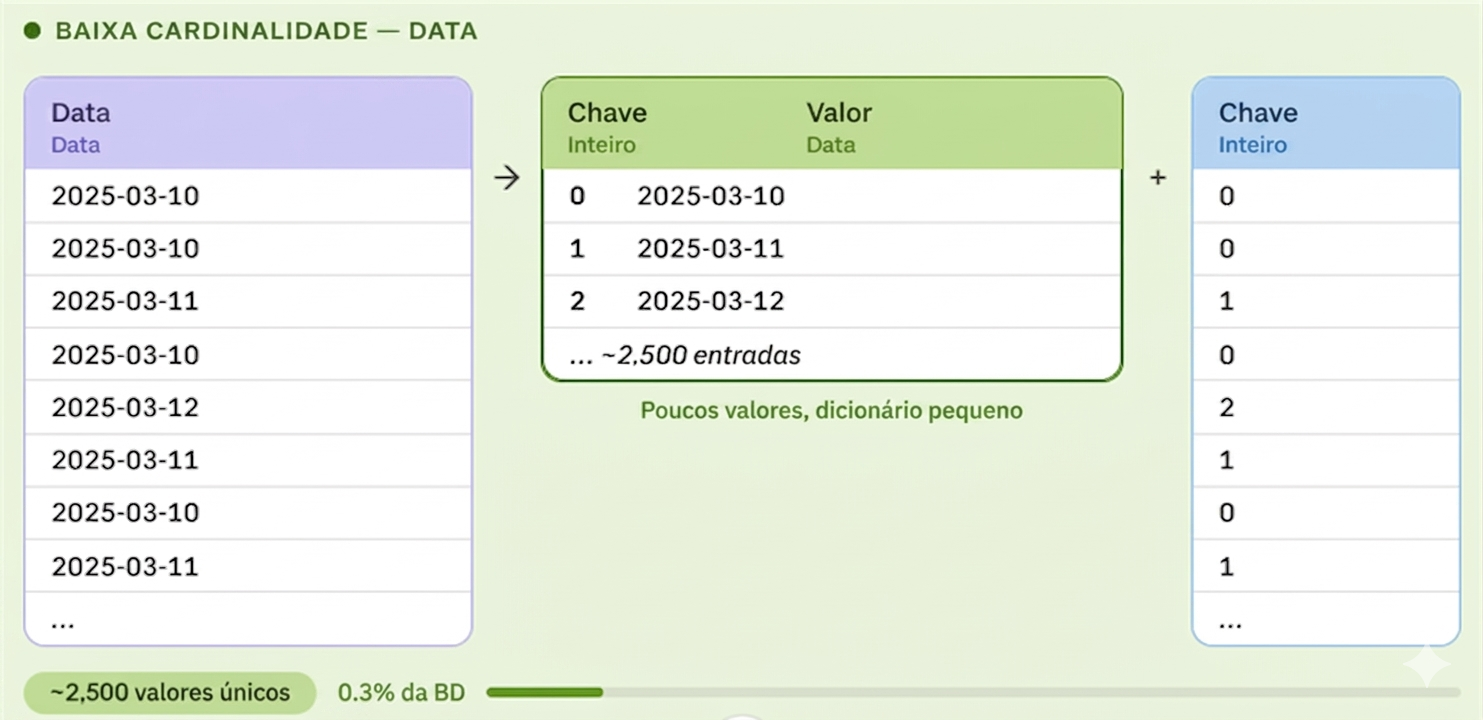
As soluções mais comuns incluem:
- Dividir colunas DateTime em colunas separadas de Data e Hora
- Reduzir a precisão (arredondar decimais)
- Evitar tipos de vírgula flutuante como Double, Single, Float para valores que requerem precisão exata
- Não utilizar tipos de dados String para colunas numéricas
Reduzir colunas desnecessárias remove estruturas completas do modelo, enquanto reduzir a cardinalidade encolhe as colunas que têm de permanecer.
Padrão 3: Desativar hierarquias de atributos desnecessárias
O Power BI cria automaticamente hierarquias de atributos para cada coluna para suportar consultas MDX (utilizadas pelas Tabelas Dinâmicas do Excel).
O problema é que a maioria destas hierarquias nunca é utilizada, mas ainda assim consomem memória.
Desativar IsAvailableInMDX remove estruturas de hierarquia não utilizadas e recupera a memória associada.
Isto é especialmente valioso porque:
- Melhora o desempenho ao evitar conjuntos de resultados desnecessariamente largos
- Devolve apenas as colunas necessárias para análise
- Impede que colunas de alta cardinalidade sejam utilizadas em Tabelas Dinâmicas
A coluna continua a ser utilizável em DAX e relatórios, mas simplesmente deixa de gerar metadados desnecessários.
Padrão 4: Utilizar agregações definidas pelo utilizador
Em alguns cenários, remover colunas de detalhe de alta cardinalidade não é uma opção. Quando isso acontece, as agregações definidas pelo utilizador constituem uma alternativa eficaz. Esta abordagem divide os dados em duas camadas:
- Consultas agregadas: rápidas, em memória
- Exploração ao nível do detalhe: retém colunas de alta cardinalidade que não podem ser importadas
A maioria das consultas utiliza a camada agregada, enquanto as consultas de exploração detalhada vão ao sistema de origem.
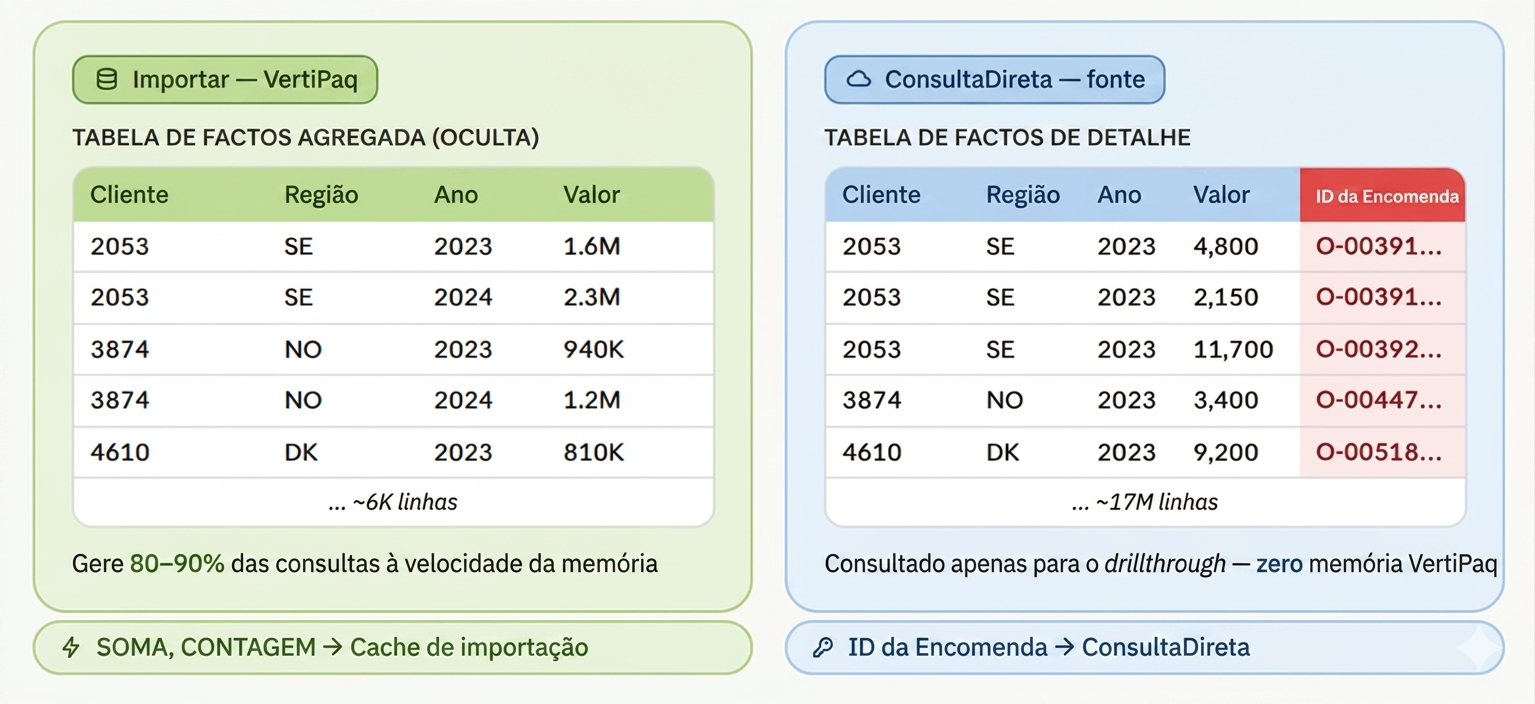
A tabela de detalhe em DirectQuery permanece parte do modelo, mas ao contrário dos dados importados, não consome memória VertiPaq.
O resultado:
- Redução significativa de memória
- Ligeiro compromisso no desempenho de consultas para vistas detalhadas
Este padrão funciona melhor quando:
- A maioria dos relatórios (cerca de 80–90%) é baseada em dados agregados
- Os dados ao nível da linha são consultados apenas ocasionalmente
- O tamanho do modelo é maioritariamente determinado por colunas de alta cardinalidade
- Quando são necessários dados detalhados, estes são geralmente muito filtrados
Padrão 5: Dividir modelos grandes em modelos mais pequenos
Em vez de um modelo grande, considere dividi-lo em modelos semânticos mais pequenos orientados por tema.
Cada modelo conteria apenas as tabelas e colunas necessárias para o seu âmbito analítico.
Este método ajuda porque:
- Os limites de memória são aplicados por modelo
- Modelos mais pequenos reduzem o consumo de memória máximo
- Governação e manutenção mais fáceis
No entanto, isto introduz complexidade:
- Os relatórios só podem ligar-se a um modelo
- A análise entre domínios torna-se mais difícil
Este padrão é mais eficaz quando os domínios são claramente distintos e existe pouca necessidade de os utilizadores realizarem análises entre domínios.
Padrão 6: Otimizar a codificação de comprimento de execução (RLE)
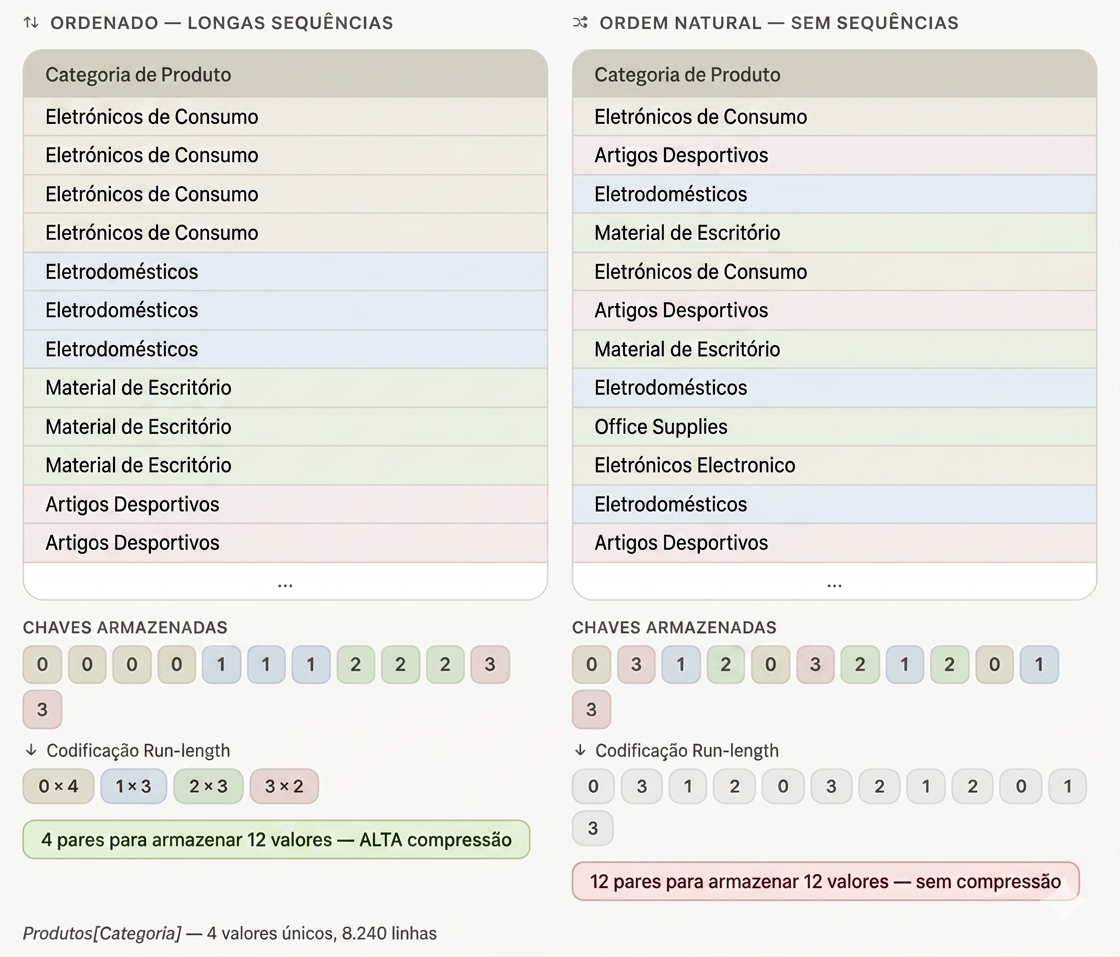
A Codificação de Comprimento de Execução (RLE) é uma técnica de compressão utilizada pelo VertiPaq.
Funciona melhor quando valores idênticos são armazenados consecutivamente. Quanto mais longa a sequência de valores idênticos no segmento da coluna, melhor a compressão.
Por outras palavras, a forma como os dados são ordenados e como as colunas são estruturadas pode influenciar o consumo geral de memória.
Este padrão vale a pena avaliar quando:
- Tabelas de factos grandes são o principal fator de consumo de memória
- Outras otimizações ao nível das colunas já foram implementadas
- O modelo não pode ser dividido em partes mais pequenas
- É necessário melhorar o desempenho sem alterar a lógica de negócio subjacente
Pode implementar o RLE através de:
- Modificação da ordem de ordenação
- Particionamento dos dados
Isto não altera os dados em si, apenas a eficiência com que são comprimidos. Em alguns casos, pode reduzir o tamanho do modelo em percentagens de dois dígitos.
Considerações finais
Este artigo explorou o que é a memória de um modelo semântico, por que razão esta é importante e como medi-la de forma eficaz. Foi também apresentada uma análise de seis técnicas práticas, desde melhorias rápidas até estratégias mais avançadas, que podem ajudar a otimizar os modelos e a melhorar o desempenho.
Ao combinar fundamentos sólidos com otimizações direcionadas, é possível:
- Manter-se dentro dos limites de memória
- Melhorar o desempenho
- Reduzir custos
- Construir modelos semânticos escaláveis e fiáveis no Fabric